Progreso JdeRobot - Semana 6 (12/10 - 16/10)
Esta semana he continuado con la integración del ejercicio de audio en RoboticsAcademy, trabajando tanto en la integración del frontend como en la aplicación de Python.
1. Creación del ejercicio
Seguí la guía para crear un ejercicio, copiando la carpeta del ejercicio Basic Computer Vision y renombrándola a audio-in para poder trabajar.
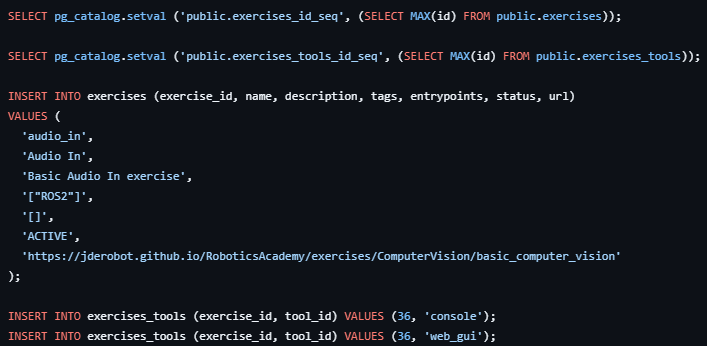
Lo siguiente fue añadir el ejercicio a la base de datos a través de Django Web Admin, pero tuve problemas desde el panel de administración. En concreto, el problema era que ya existía un ejercicio con el id 1. Investigando el dump de la base de datos, encontré que esto estaba relacionado con la siguiente línea:
1
SELECT pg_catalog.setval('public.exercises_id_seq', 1, false);
El mismo problema ocurrió al añadir las tools en la tabla exercises_tools. Finalmente, lo solucioné cargando un archivo que contiene todo el SQL necesario para añadir correctamente el ejercicio a la base de datos.
2. Integración del frontend y de la aplicación de Python
Tras crear el ejercicio audio-in y comprobar que se mostraba correctamente en RoboticsAcademy, empecé a pasar el código del frontend a React, integrándolo dentro de WebGui.tsx del ejercicio. También integré el código de mi aplicación de Python en WebGui.py. Para poder utilizar el código JavaScript del AudioWorklet, tuve que introducirlo dentro de un Blob, evitando así problemas relacionados con los enlaces al archivo.
Al principio, implementé un botón para empezar a grabar el audio, que al pulsarlo captura el flujo procedente del micrófono. Después comprobé que el Processor del AudioWorklet recibe correctamente los bloques de audio de 512 muestras, que es lo que se procesa en cada iteración. Una vez comprobado el funcionamiento en el frontend, conecté este flujo con la aplicación de Python integrada en WebGui.py, que ya devuelve el texto transcrito. Posteriormente, lo implementé sin botón, de forma que la captura del audio se inicia sin necesidad de pulsar nada.
El siguiente paso fue implementar en la parte del usuario un método listen que permite obtener las transcripciones anteriores a los segundos que se indiquen como parámetro. De este modo, es la propia aplicación la que recibe el texto correspondiente al audio escuchado y se encarga de imprimir ese string por terminal.
Finalmente, ahora tenemos que integrar en un mismo ejercicio llamado HRI-sound toda la funcionalidad audio-in y audio-out.
3. Dependencias de la aplicación
Hasta el momento, instalaba dentro del contenedor las librerías necesarias para ejecutar mi aplicación. Esto significa que, al inicializar de nuevo el proyecto, tenía que volver a instalar dichas dependencias manualmente. Para ahorrar tiempo en cada arranque, habría que instalarlas en la imagen de Docker Dockerfile.dependencies_humble, de forma que formen parte del entorno de ejecución del ejercicio.
Planes para la Siguiente Semana
- Añadir las dependencias necesarias de la aplicación a la configuración de Docker.
- Integrar el trabajo en el ejercicio HRI-audio.